


KI-Beschleunigung und GPU-Überwachung mit Entuity
Behalten Sie den Überblick über alle GPUs in Ihrer Umgebung und die Kühlsysteme, die deren Betrieb gewährleisten, bevor ein Fehler Ihre Workloads zum Erliegen bringt. „ Entuity “ überwacht NVIDIA®-, AMD®- und Intel®-Beschleuniger sowie die dazugehörigen Server, Verbindungsstrukturen und Flüssigkeitskühlsysteme – alles über eine zentrale Oberfläche in Ihrer eigenen Infrastruktur.
Wie „ Entuity “ Ihre größten Herausforderungen im Bereich der KI-Infrastruktur löst
Integrieren Sie Ihre KI-Hardware in die gleiche Übersicht wie den Rest Ihrer Infrastruktur, ohne ein weiteres Tool hinzuzufügen.
Eine umfassende Übersicht über alle Beschleuniger verschiedener Hersteller
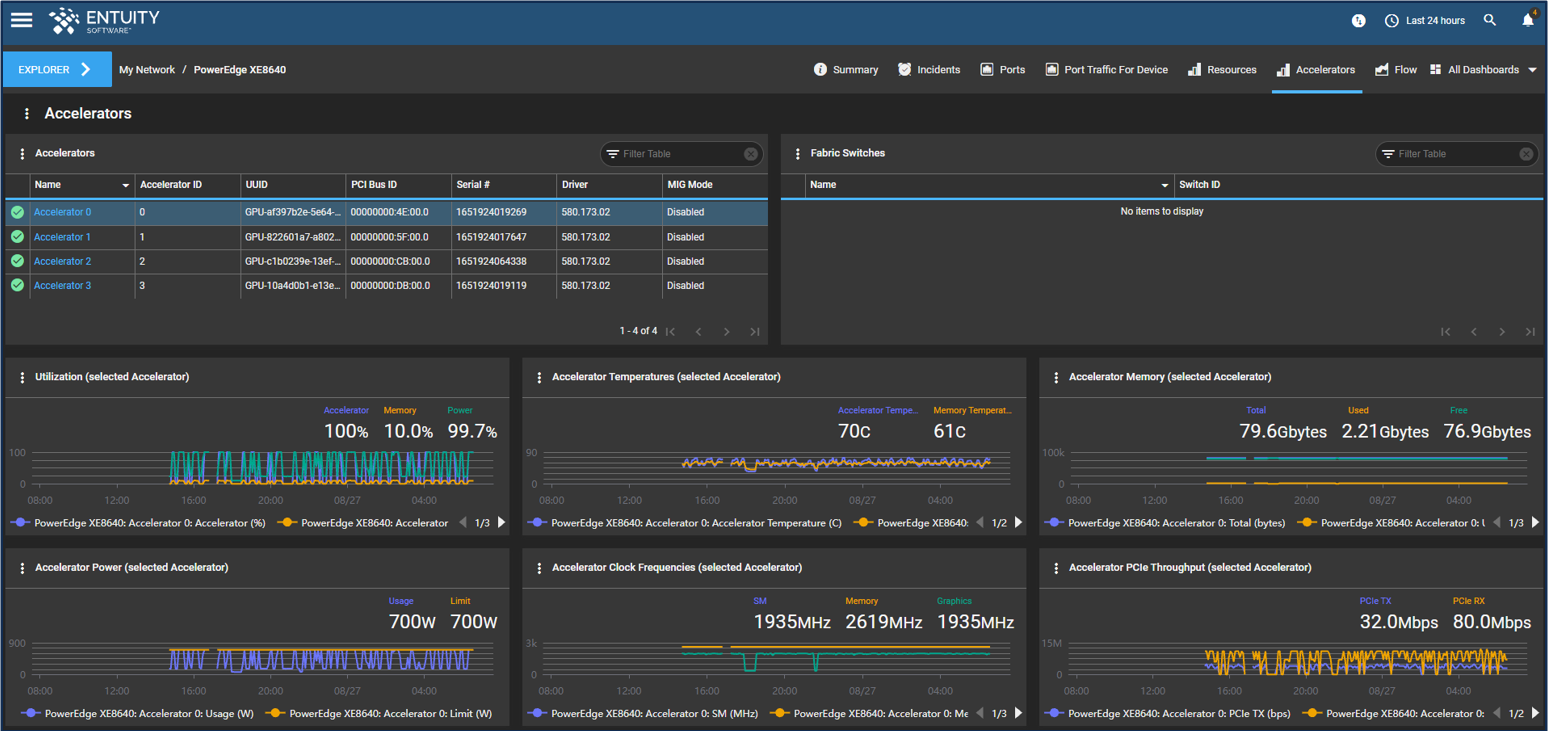
Beginnen Sie beim Server, fassen Sie alle Beschleuniger in einer einheitlichen Ansicht zusammen und zoomen Sie dann auf einzelne GPUs, um Auslastung, Wärmeentwicklung, Stromverbrauch und den Betriebszustand in Echtzeit zu überprüfen.
KI-Umgebungen bestehen selten nur aus Geräten eines einzigen Anbieters. „ Entuity “ überwacht Beschleuniger von NVIDIA, AMD und Intel – einschließlich Intel Gaudi – auf einer einzigen Plattform. Es erkennt automatisch, welche Anbieter-Tools ein Host unterstützt, und überwacht einen Server mit Geräten verschiedener Anbieter als ein einziges Gerät.
Die Überwachung auf Serverebene beschränkt sich allein auf den Host. „ Entuity “ modelliert fünf Objekttypen unterhalb des Servers: das GPU-Gerät, GPU-Instanzen wie NVIDIA-MIG-Partitionen, AMD-Partitionen und virtuelle Intel-SR-IOV-Funktionen, Recheninstanzen, GPU-Verbindungen und GPU-Fabric-Switches.
Ihre Beschleuniger laufen nicht isoliert. „ Entuity “ integriert sie in dieselbe Plattform und in dieselbe Vorfall-Zeitleiste wie das Netzwerk, die Server, den Speicher und die Stromversorgung, auf die sie angewiesen sind.
Erkennen Sie Hardwarefehler, bevor sie Ihre Workloads zum Stillstand bringen
GPU-Ausfälle treten selten ohne Vorwarnung auf. „ Entuity “ überwacht die Zählerstände, die frühzeitig auf Probleme hinweisen, sodass Ihr Team Maßnahmen ergreifen kann, während die Workloads noch laufen.
Speicherfehler sind oft das erste Warnsignal, das eine GPU aussendet. „ Entuity “ überwacht die Zähler für korrigierte und unkorrigierte ECC-Fehler auf jeder GPU, wobei standardmäßig Schwellenwerte aktiviert sind, die bei jedem Anstieg ausgelöst werden. Eine Karte, die keine Daten mehr meldet, wird als fehlend markiert, anstatt stillschweigend zu verschwinden.
Verbindungsausfälle sind eine der Hauptursachen für Ausfallzeiten von GPU-Clustern, und eine Verbindung, die zwar noch besteht, deren Leistung jedoch nachlässt, kann leicht übersehen werden. „ Entuity “ überwacht die Verbindungen zwischen Ihren GPUs, darunter NVIDIA NVLink®, AMD xGMI, Intel Xe Link und Gaudi-Ports. Die Lösung erfasst den Verbindungsstatus, die Bandbreite sowie die Fehlerzähler für CRC-, Replay- und Wiederherstellungsfehler.
Einblick auf Switch-Ebene in GPU-Fabric-Switches, einschließlich NVIDIA NVSwitch™, zeigt Temperatur, Bandbreite sowie Zähler für schwerwiegende und nicht schwerwiegende Fehler an. Ihr Team erkennt frühzeitig Anzeichen einer Verschlechterung der Verbindungsqualität und kann proaktiv Maßnahmen ergreifen, anstatt erst nach einem Ausfall eine Diagnose zu stellen.

Überwachen Sie die Kühlung, die den Betrieb Ihrer Beschleuniger gewährleistet
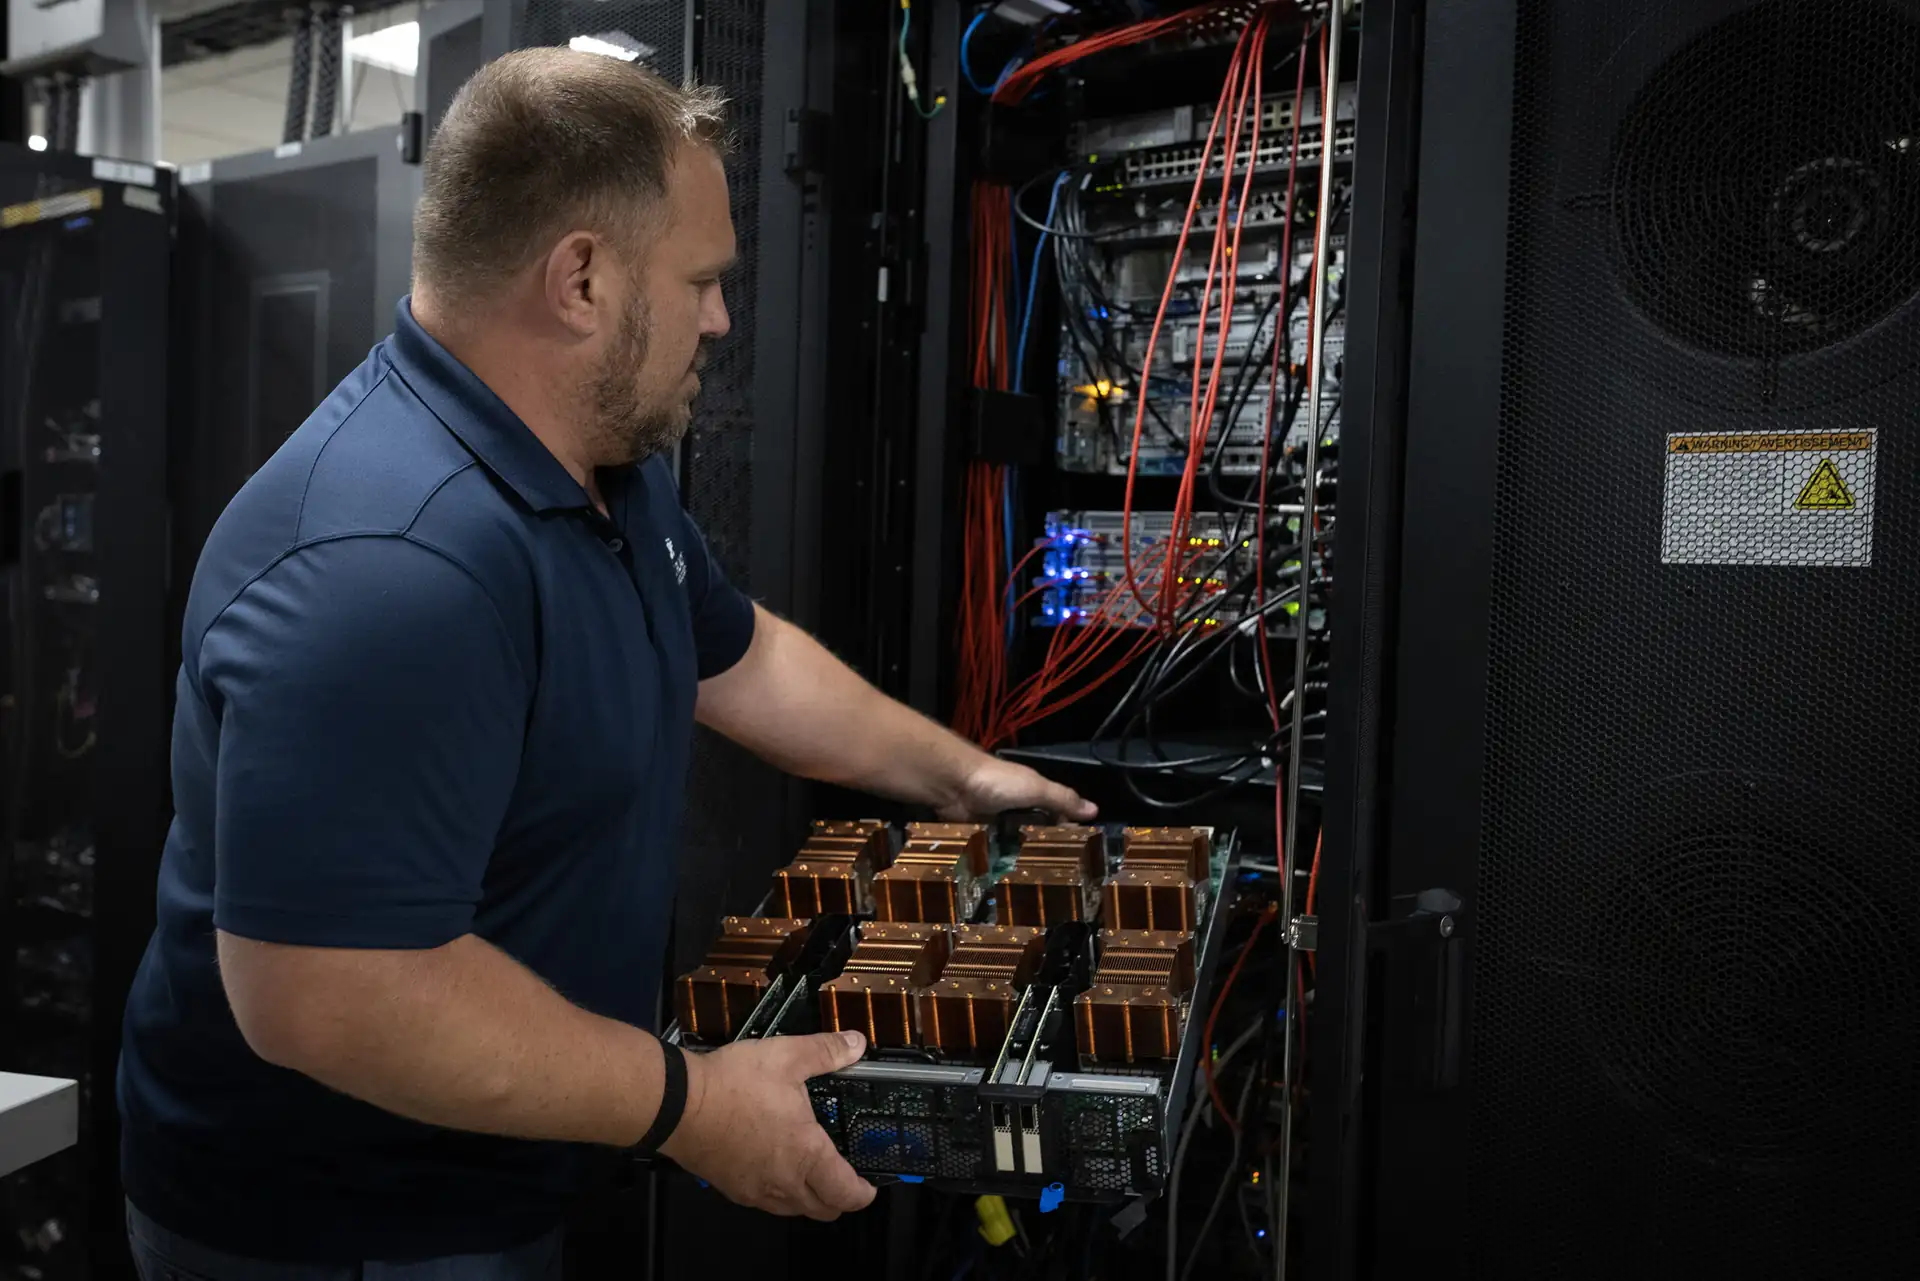
Flüssigkeitsgekühlte Server sind vollständig von der sie umgebenden Kühlinfrastruktur abhängig. „ Entuity “ bündelt diese Infrastruktur in derselben Ansicht wie die Rechenressourcen, die sie schützt.
Entuity bietet sofort einsatzbereite Unterstützung für Immersions- und Direct-to-Chip-Flüssigkeitskühlung von führenden Anbietern, darunter ACCELSIUS™, GRC®, nVent® und ZutaCore®. Dabei werden die Daten direkt vom Kühlungsregler erfasst, anstatt sie über das Gebäudemanagementsystem weiterzuleiten.
Überwachen Sie den Durchfluss und die Drehzahl der Pumpe sowie die Rückmeldung, die Vor- und Rücklauftemperatur des Kühlmittels und deren Differenz sowie den System- und Verteilerdruck. „ Entuity “ erfasst außerdem den Füllstand des Vorratsbehälters, die Ventilstellung und den Sollwert, die Leckageerkennung sowie die Gestell- und Lufttemperaturen.
Wenn ein Kühlungsalarm und eine GPU-Temperaturwarnung auf derselben Vorfall-Zeitleiste erscheinen, sieht Ihr Team Ursache und Folge auf einen Blick. Niemand muss um 2 Uhr morgens Daten aus verschiedenen Systemen miteinander abgleichen.
Eine Überwachungsplattform. Vollständige Transparenz der KI-Infrastruktur.
-
Überwachung von Beschleunigern verschiedener Hersteller
- Überwachen Sie NVIDIA-, AMD- und Intel-GPUs sowie Beschleuniger, einschließlich Intel Gaudi, über eine einzige Plattform. „ Entuity “ erfasst die Daten über die herstellerspezifischen Tools (nvidia-smi mit DCGM-Profiling, amd-smi, xpu-smi und hl-smi) und wählt automatisch den passenden Datenerfasser für jeden Host aus.
-
Telemetriedaten zu GPU-Zustand und -Fehlern
- Verfolgen Sie ECC-korrigierte und unkorrigierte Fehler, Link-CRC-, Wiedergabe- und Wiederherstellungsfehler sowie schwerwiegende und nicht schwerwiegende Fabric-Fehler. Jede GPU verfügt über einen Standard-Komponentenstatus, sodass eine fehlende oder nicht reagierende Karte sofort gemeldet wird.
-
GPU-Partition und Sichtbarkeit von Instanzen
- GPU-Instanzen, darunter NVIDIA-MIG-Partitionen, AMD-Partitionen und virtuelle Intel-SR-IOV-Funktionen, werden ebenso wie Recheninstanzen als vollwertige Objekte überwacht. Durch die Erfassung der Speichernutzung pro Partition wird verhindert, dass eine inaktive Partition auf Kartenebene im Durchschnitt untergeht.
-
Überwachung von Verbindungsstrukturen und GPU-Fabric
- Überwachen Sie NVLink-, xGMI-, Xe Link- und Gaudi-Verbindungen hinsichtlich der Anzahl der Verbindungen, aktiver und inaktiver Verbindungen, Bandbreite, Sende- und Empfangsraten sowie Fehlerzählern. GPU-Fabric-Switches, einschließlich NVSwitch, melden Temperatur, Bandbreite und Fehlerzähler.
-
Auslastung & Kapazität
- Überwachen Sie die GPU- und Speicherauslastung, den Gesamtspeicher, den belegten und freien Speicher sowie die Engine-Aktivität und die SM-Auslastung, sofern der Hersteller diese Daten bereitstellt. Ihr Team kann so zwischen einer ausgelasteten GPU und einer lediglich zugewiesenen GPU unterscheiden.
-
Leistungsüberwachung
- Überwachen Sie den Stromverbrauch, die festgelegte Leistungsgrenze und die Leistungsauslastung als Prozentsatz dieser Grenze. Die maximalen und standardmäßigen Leistungsgrenzen werden pro Karte erfasst, sodass eine Leistungsbegrenzung, die den Durchsatz unbemerkt einschränkt, sichtbar wird.
-
Temperaturüberwachung
- Überwachen Sie die GPU- und Speichertemperatur, die Lüfterdrehzahl sowie die SM-, Speicher- und Grafiktaktfrequenzen. Die vom Hersteller angegebenen Abschalt- und Drosselungstemperaturen jeder Karte werden als Bestandsdaten erfasst, sodass Ihr tatsächlicher thermischer Spielraum sichtbar ist und nicht nur angenommen wird.
-
Überwachung der Flüssigkeitskühlung
- Sofort einsatzbereite Unterstützung für Immersions- und Direct-to-Chip-Flüssigkeitskühlung von ACCELSIUS, GRC, nVent und ZutaCore. Überwachen Sie die Telemetriedaten zu Pumpe, Kühlmittel, Druck, Vorratsbehälter, Ventil und Leckageerkennung direkt über den Controller.
-
In-Band- und Out-of-Band-Erfassung
- Die Erfassung erfolgt „in-band“ über SSH oder lokal sowie „out-of-band“ über Redfish mittels Dell iDRAC und HPE iLO. Sind beide Wege verfügbar, hat „in-band“ Vorrang, sodass keine GPU doppelt gezählt wird.
-
Bereit für den Alarmbetrieb vom ersten Tag an
- Standardmäßig sind vierzehn GPU-Schwellenwerte aktiviert, die Temperatur, Speicher, Lüfterdrehzahl, Auslastung, Stromverbrauch, ECC-Fehler, Verbindungsstatus und Fabric-Fehler abdecken. Jeder Schwellenwert kann an Ihre Umgebung angepasst werden.
-
Von vornherein schreibgeschützt
- Entuity Es überwacht die GPU-Einstellungen, Taktraten und Partitionierung, ohne diese zu verändern, und es ist kein Root-Zugriff erforderlich. Dadurch lässt es sich in streng kontrollierten Umgebungen problemlos genehmigen.
Beobachtbarkeit der KI-Infrastruktur
Entuity bietet Transparenz vom Server bis hinunter zur einzelnen GPU-Partition und bis hin zur Kühlanlage und überwacht den Zustand, die Leistung und die Betriebsumgebung Ihrer KI-Infrastruktur. Damit erhält Ihr Team Echtzeit-Einblicke, um Probleme zu erkennen und zu beheben, bevor sie den Betrieb beeinträchtigen.



Produkt-Tour auf Abruf
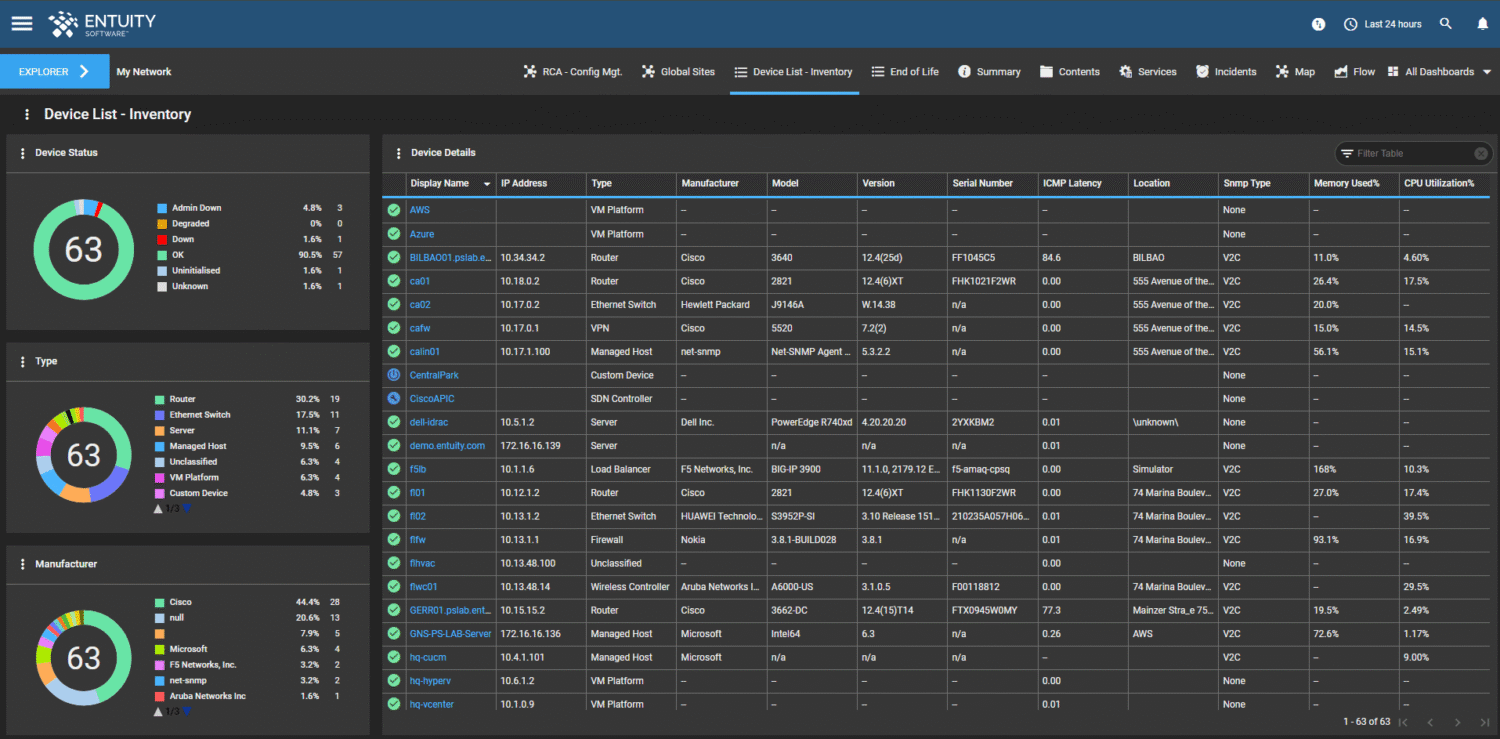
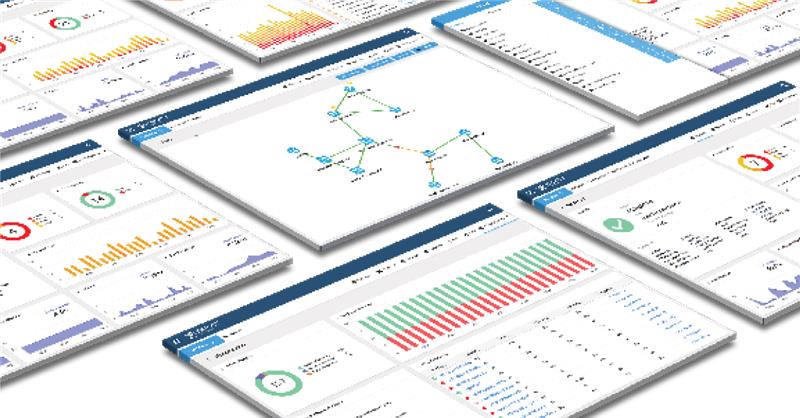
Entwickelt für die komplexen IT-Umgebungen von heute – Entuity ITOps-Teams, ihre Infrastruktur effektiv zu überwachen, zu visualisieren und zu verwalten. Erfahren Sie, wie die Lösung Ihnen umfassende Transparenz über Ihr Netzwerk, Ihre Server und Ihre Speichersysteme bietet. Entdecken Sie automatisierte Topologie-Kartierung, intelligente Warnmeldungen und leistungsstarke Berichtsfunktionen zur Optimierung Ihres IT-Betriebs.
Seit 17 Quartalen in Folge an der Spitze.
G2-Nutzer sind von Entuity begeistert und stufen das Unternehmen als weltweit führenden Anbieter im Bereich Netzwerk- und Infrastrukturüberwachung ein.





Unternehmen, die auf Entuity vertrauen





Erfahrungsberichte von Kunden

Möchten Sie mehr erfahren oder eine Demo vereinbaren?
Machen Sie eine geführte Tour durch die Netzwerküberwachung in „ Entuity “: automatische Erkennung und Topologieabbildung, intelligente Warnmeldungen, die überflüssige Informationen ausblenden, und Berichte, die die eigentliche Ursache deutlich machen. Möchten Sie sehen, wie sich das auf Ihre eigene Umgebung auswirkt? Buchen Sie eine individuelle Demo, und unser Team zeigt Ihnen genau, wie „ Entuity “ zu Ihrem Netzwerk passt.
Buchen Sie eine individuelle Vorführung
Wichtige Funktionen für die Überwachung von KI-Beschleunigern
-
Entuity Überwacht GPUs und Beschleuniger von AMD, Intel und NVIDIA, einschließlich Intel Gaudi, auf einer einzigen Plattform. Server mit Komponenten verschiedener Hersteller werden als ein einziges Gerät überwacht.
-
Entuity geht über die GPU selbst hinaus und überwacht Partitionen, Recheninstanzen, GPU-Verbindungen und Fabric-Switches. Es verfolgt die Fehlerzähler, die Hardwareprobleme signalisieren, bevor diese die Arbeitslasten unterbrechen.
-
Entuity Unterstützt die Tauch- und Direct-to-Chip-Flüssigkeitskühlung von ACCELSIUS, GRC, nVent und ZutaCore. Das System erfasst Telemetriedaten zu Pumpe, Kühlmittel, Druck und Leckageerkennung direkt vom Controller.
-
Entuity Läuft auf Ihrer eigenen Infrastruktur und nimmt keinerlei Änderungen an GPU-Einstellungen, Taktraten oder der Partitionierung vor. Root-Zugriff ist nicht erforderlich, was die Genehmigung in streng kontrollierten und von der Außenwelt isolierten Umgebungen vereinfacht.
-
Die Daten zu GPUs und Kühlung werden auf derselben Plattform gespeichert wie Ihre Netzwerk-, Server-, Speicher- und Anwendungsüberwachung. Vorfälle im Zusammenhang mit Beschleunigern fließen in dieselben Systeme für Ereignismanagement, Korrelation und ITSM-Integrationen ein, die Ihr Team bereits nutzt.
Empfohlene Ressourcen: Whitepaper, Fallstudien und Blogs



Erste Schritte mit Entuity
Sind Sie bereit, Entuity Aktion zu erleben? Überwachen, visualisieren und verwalten Sie Ihren Bestand ganz einfach.